
Models
LG AI연구원에서 개발한 대형 언어모델 K-EXAONE 2.5와 정형 데이터 특화 모델인 EXAONE Tabular를 소개합니다.
K-EXAONE 2.5
K-EXAONE 2.5는 한국어 이해와 생성에 강점을 갖춘 고성능 모델입니다. 코드 작성·분석·디버깅 등 다양한 소프트웨어 개발 작업을 지원합니다. 긴 문맥과 복잡한 도구 호출 지시를 이해하여 업무와 에이전트 작업에 폭넓게 활용할 수 있습니다.
- Intelligence
- Higher
- Speed
- Medium
- Context length
- 512K
- Max output tokens
- 512K
- Knowledge cutoff
- 2026-01
| Model Training | 연속 사전 학습부터 후속 학습까지, 고품질 합성 데이터 방법론을 적용해 모델의 학습 품질을 높였습니다. 여기에 이상 데이터 감지 시스템으로 학습 데이터를 정교하게 선별하고 개선해, 모델 성능을 한층 끌어올렸습니다. | ||||||||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Modalities | Text | ||||||||||||||||||||||||||||||
| Languages | 한국어 / 영어 | ||||||||||||||||||||||||||||||
| Parameters | 750B(Active 31B) | ||||||||||||||||||||||||||||||
| Features | Chat / Tool calling / Structured outputs / Code generation / Streaming | ||||||||||||||||||||||||||||||
| Benchmarks | K-EXAONE 2.5는 이전 세대 모델 대비 에이전틱 코딩, 검색, 도구 사용 전 영역에서 성능이 크게 향상되었으며, 동급 오픈 웨이트 모델인 DeepSeek-V4.1-Flash, GLM-5.3과 대등한 수준의 성능을 보입니다. | ||||||||||||||||||||||||||||||
| |||||||||||||||||||||||||||||||
EXAONE Tabular
- 1위 Top-Ranked on TabArena
- TabArena 분류 1위·회귀 2위 글로벌 정형 데이터 벤치마크 최상위권
- 1위 Proven Across Benchmarks
- TabBench·Bio·RelBench 바이오 분류·회귀 및 관계형 데이터 분류 1위
- Multimodal Extended to Text & Image
- STRABLE·MulTaBench 정형 데이터에 텍스트·이미지 임베딩을 결합한 멀티모달 예측에서도 우수한 성능
- 21M Small Model, Exceptional Performance
- Google TabFM 대비 약 1.3% 규모 압도적인 경량화로 최상위권 예측 성능 구현
EXAONE Tabular는 v1 공개와 동시에 글로벌 정형 데이터 AI 벤치마크 TabArena에서 분류 1위·회귀 2위를 달성하며, 세계 최고 수준의 예측 성능을 입증하였습니다.
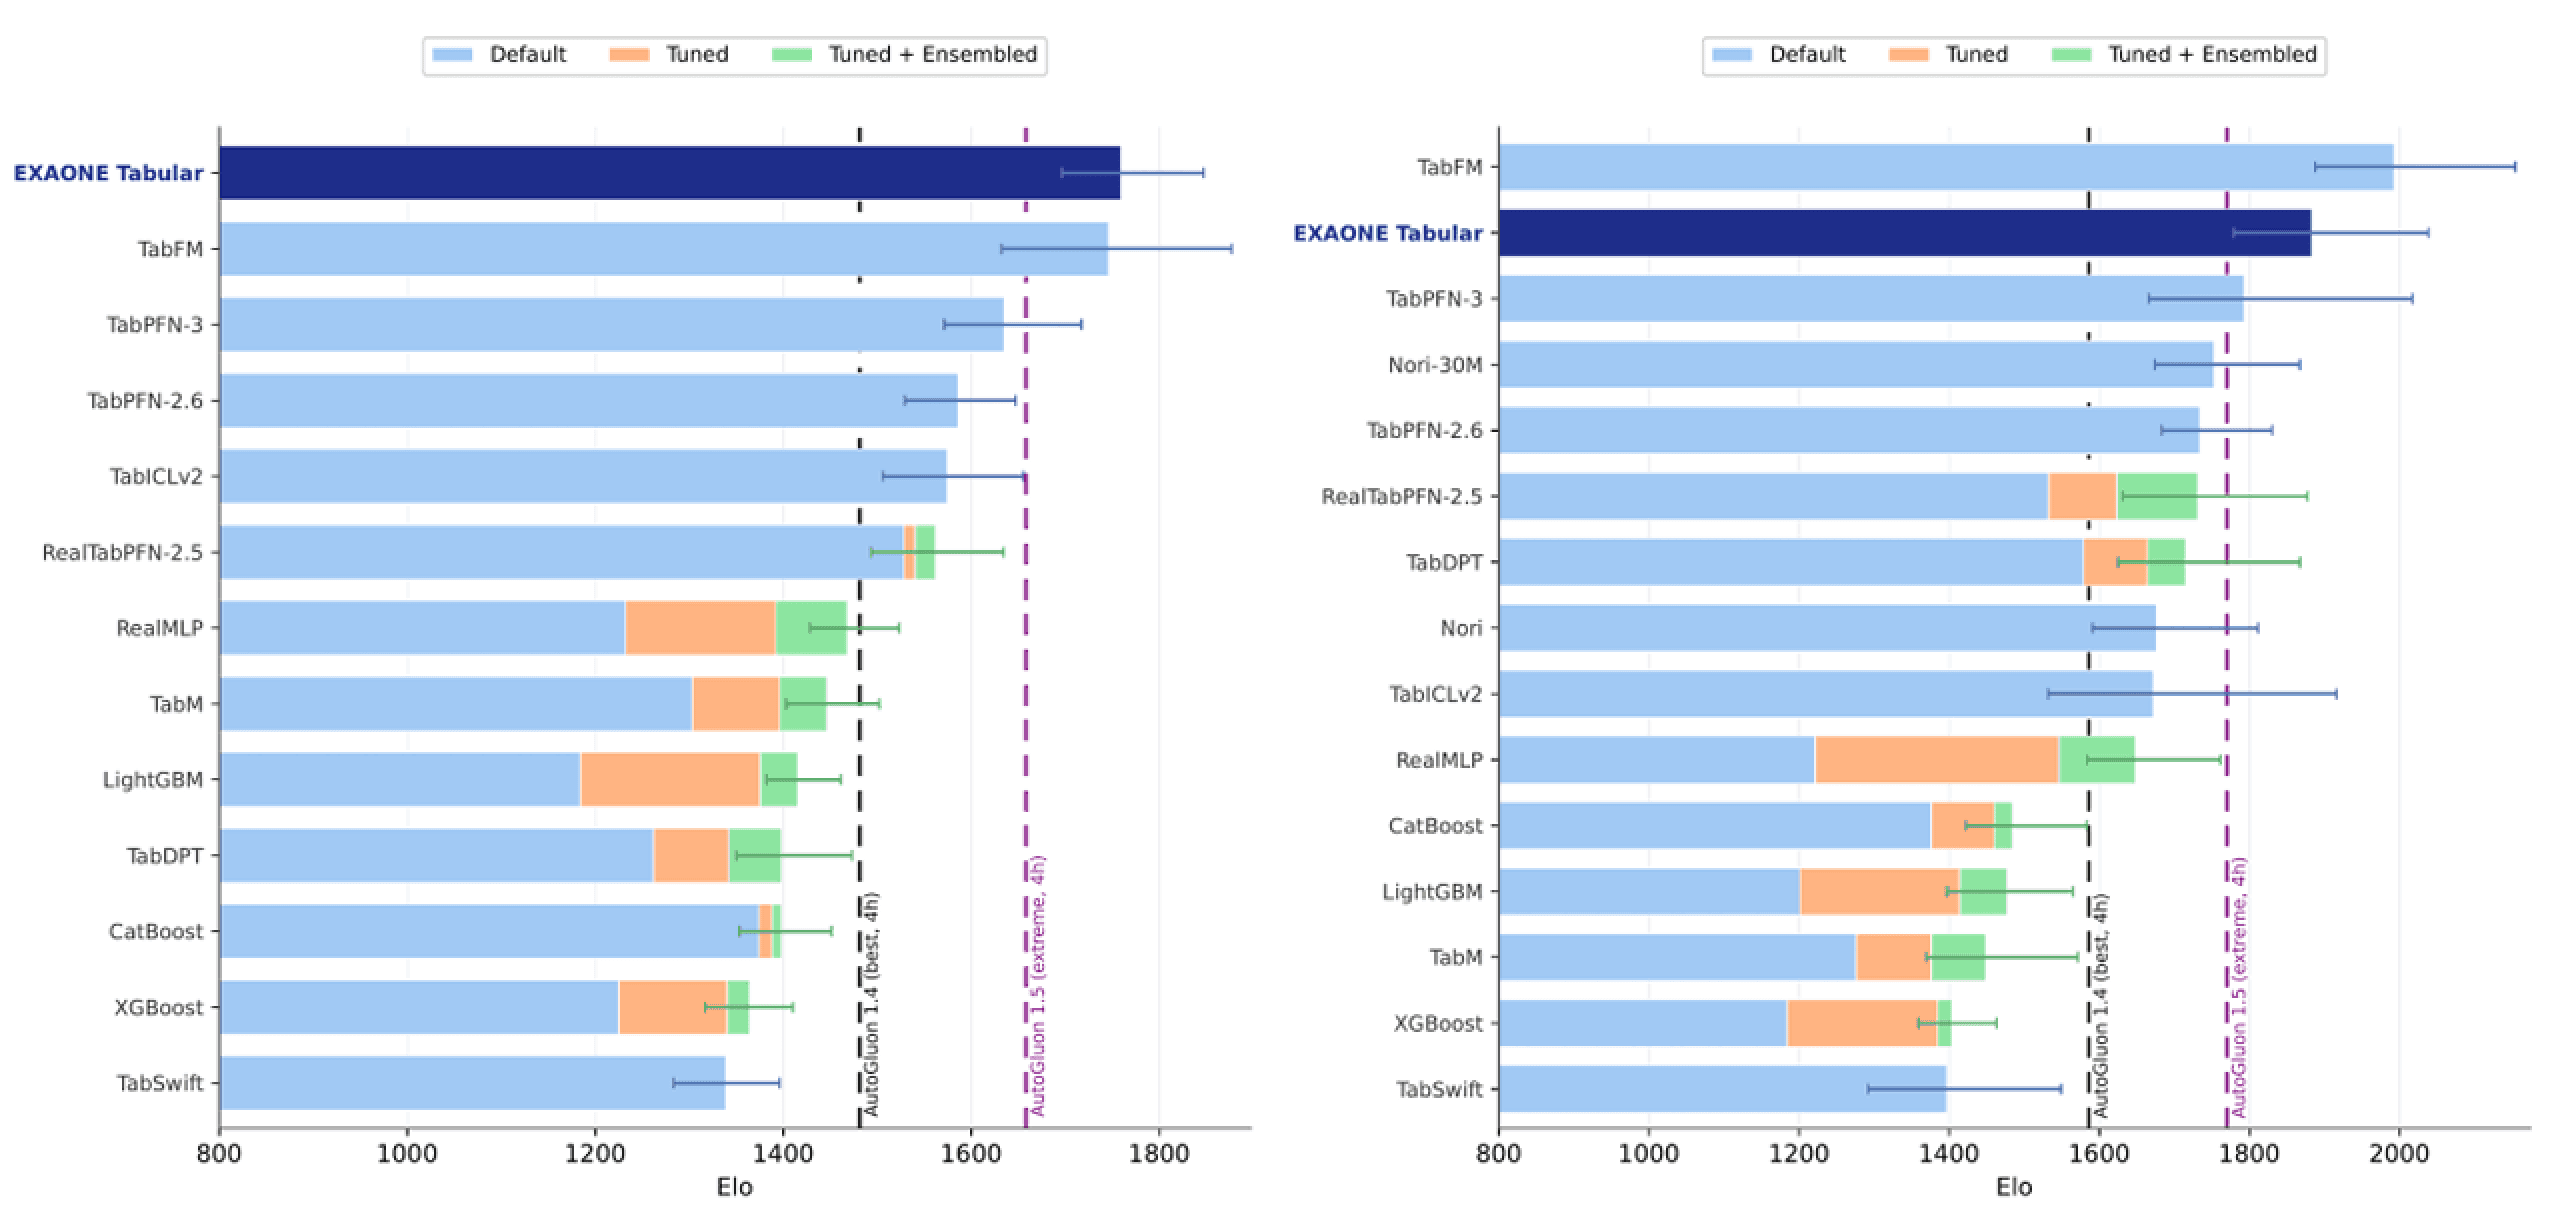
TabBench-Bio 분류·회귀와 RelBench 분류에서도 1위를 기록하며, 다양한 예측 과제에서 뛰어난 경쟁력을 보여주었습니다.
세계 최고 수준의 성능을 단 2,100만 개의 파라미터로 구현하였습니다. 구글의 정형 데이터 파운데이션 모델 TabFM 대비 약 1/78에 불과한 모델 규모로 높은 예측 성능을 달성하여, 정확도와 효율성을 동시에 추구합니다.
정형 데이터를 넘어 텍스트와 이미지까지 활용할 수 있습니다. 텍스트·이미지 임베딩을 정형 데이터와 결합해 예측하며, STRABLE·MulTaBench 등 주요 멀티모달 벤치마크에서도 최상위권 성능을 기록하였습니다.